
Zacięty wyścig na poletku sztucznej inteligencji trwa. Dopiero co firma Anthropic wypuściła model Claude Fable 5.2, który właściwie w każdej sferze okazał się lepszy niż GPT. Eksperci z OpenAI nie kazali jednak długo czekać na odpowiedź i już odzyskali prowadzenie.
GPT-6.2 Sol i GPT-6.2 Astra – dzięki nim OpenAI odzyskuje prowadzenie
Firma OpenAI udostępniła dwa nowe modele: GPT-6.2 Sol oraz GPT-6.2 Astra. Pierwszy z nich jest sprytniejszy i bardziej efektywny pod względem kosztów, co czyni go dobrym wyborem na co dzień. Drugi zaś został zaprojektowany z myślą o profesjonalnych zastosowaniach, wymagających głębokiego zgłębiania tematów i wieloetapowego rozumowania.
Twórcy chwalą się, że nowe modele generują treści, które mniej przypominają dzieło sztucznej inteligencji. Dokumenty tekstowe, slajdy prezentacji i arkusze kalkulacyjne mają brzmieć bardziej naturalnie, kod oprogramowania być czystszy i działający lepiej, a analiza informacji – przeprowadzana precyzyjniej i mniej powierzchownie.
Testy nie pozostawiają wątpliwości
Testy wykazały, że nowe modele GPT rzeczywiście dogoniły konkurenta z serii Claude pod względem oferowanych możliwości. Najlepsze jest jednak to, że pozwalają uzyskać podobne efekty, generując przy tym wyraźnie niższe koszty. Nie dość, że zużywają mniej tokenów na zadanie, to jeszcze same tokeny są niedrogie: w przypadku GPT-6.2 Sol milion tokenów wejściowych kosztuje 2 dolary, a wyjściowych – 10 dolarów, zaś w GPT-6.2 Astra, odpowiednio, 8 dolarów i 40 dolarów.
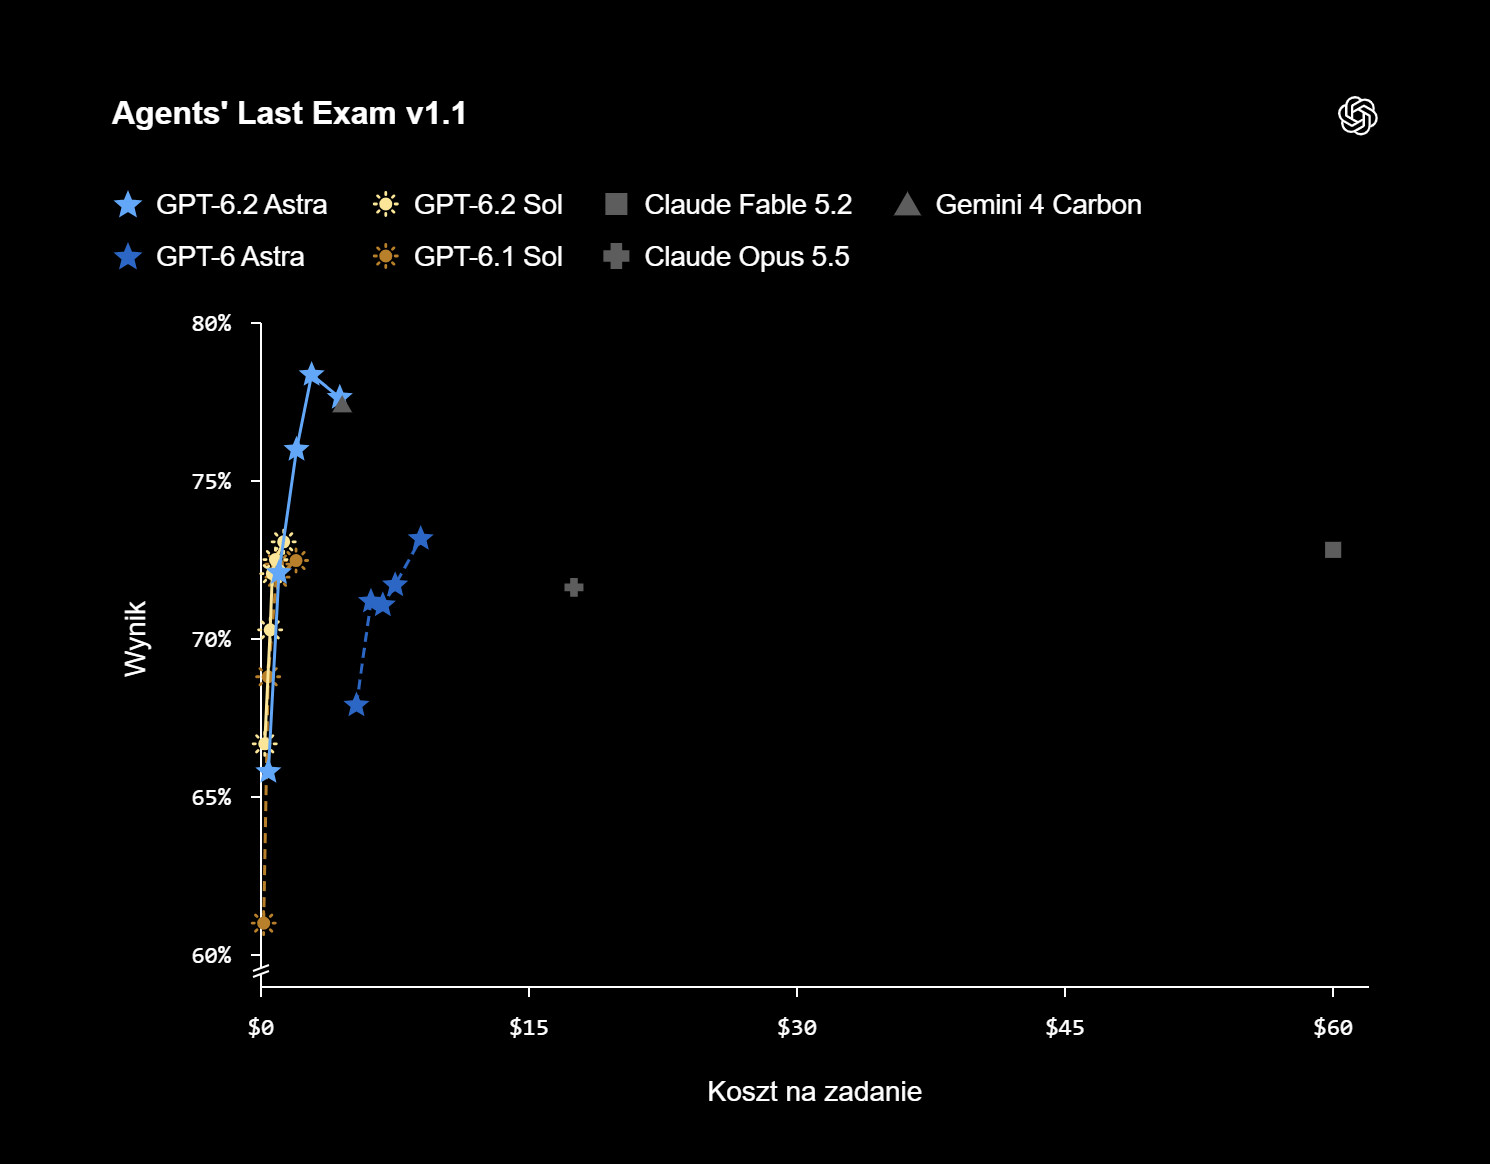
W benchmarku Agent’s Last Exam, sprawdzającym wielodziedzinowe rozumowanie w zadaniach zawodowych, Fable 5.2 osiągnął wynik 72,8%, generując koszt na poziomie 60 dolarów, podczas gdy GPT-6.2 Sol uzyskał 73% za… 1,32 dolara, a GPT-6.2 Astra – 78,3% za niespełna 3 dolary.
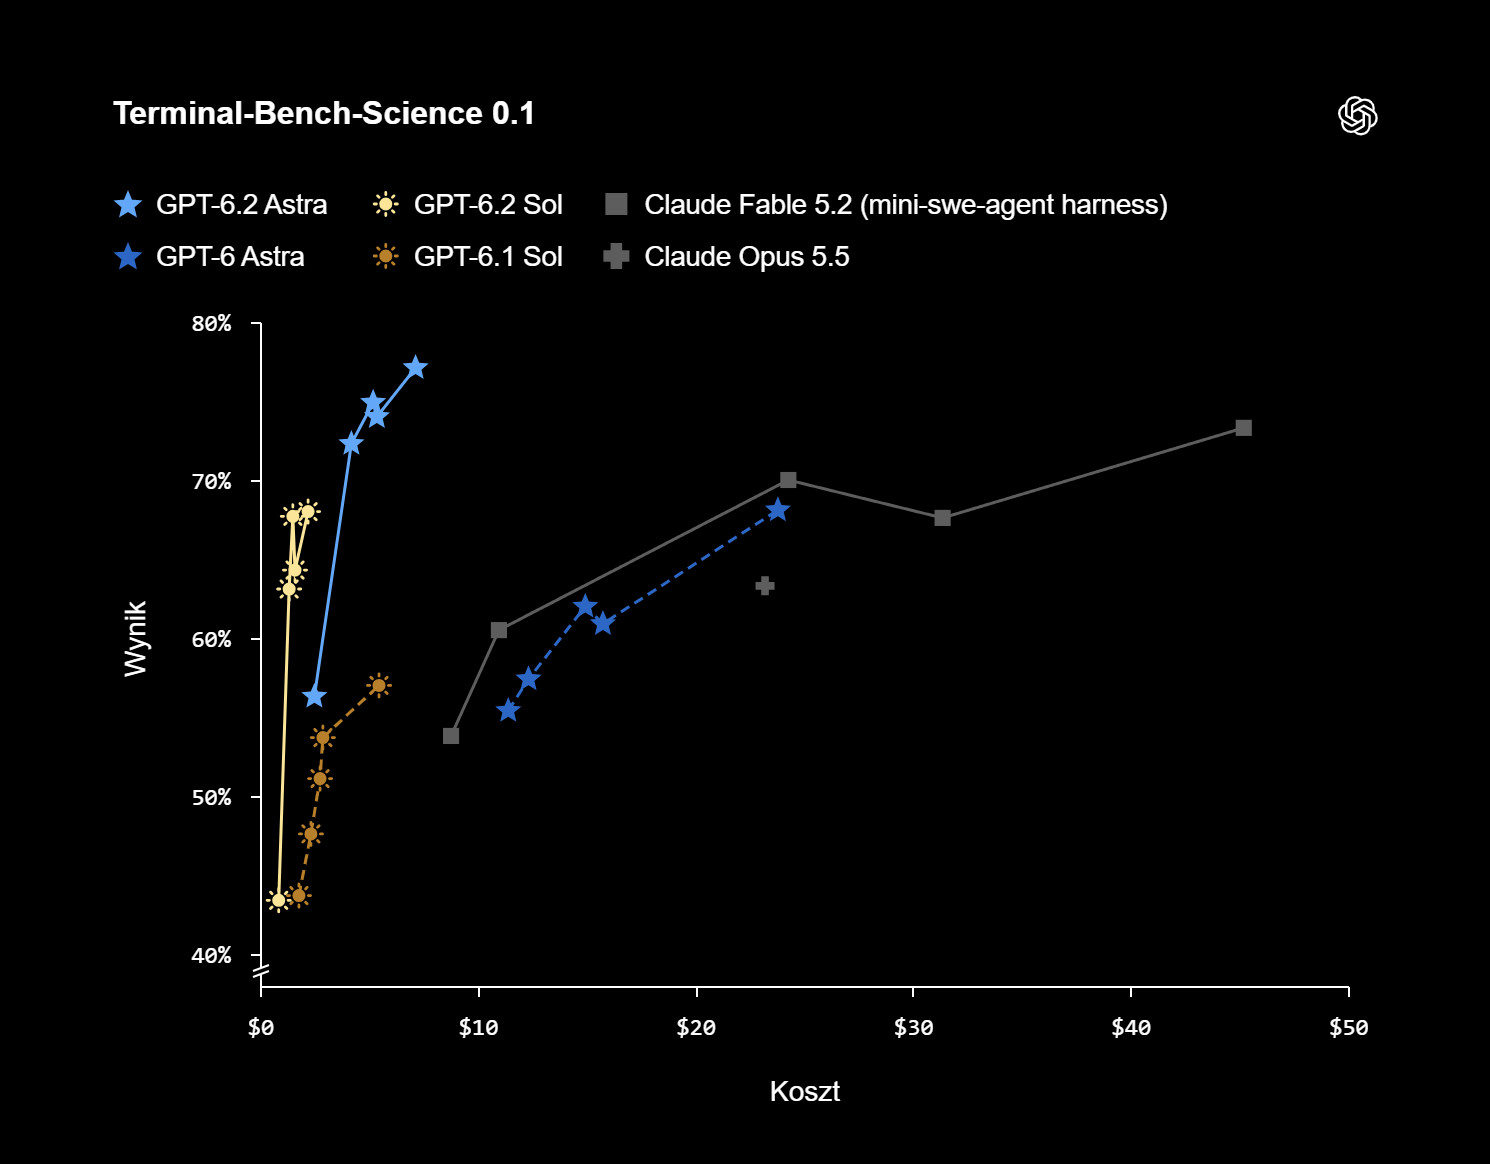
Z kolei w Terminal-Bench Science, który bada zdolność do wykonywania pracy naukowej w terminalu, Fable 5.2 uzyskał wynik 73,3% za nieco ponad 45 dolarów, GPT-6.2 Sol tylko 68%, ale za 2,21 dolara, natomiast GPT-6.2 Astra – ponad 77% za 7,15 dolara.
W niektórych benchmarkach nowe modele GPT wygrywają pod każdym względem z Claude Fable 5.2, w innych nieznacznie przegrywają, ale pozwalają osiągnąć prawie tę samą jakość za ułamek ceny. OpenAI może więc odtrąbić niemały sukces. Oto krótkie podsumowanie:
| Benchmark | Kategoria | Claude Fable 5.2 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|---|---|
| Agent’s Last Exam | Wielodziedzinowe rozumowanie | Wynik: 72,8%; koszt: 60,05 dol. | Wynik: 78,3%; koszt: 2,89 dol. | Wynik: 73%; koszt: 1,32 dol. |
| AutomationBench | Procesy biznesowe | Wynik: 51,4%; koszt: 4,64 dol. | Wynik: 52,4%; koszt: 0,83 dol. | Wynik: 41,2%; koszt: 0,21 dol. |
| BenchCAD Core | Tworzenie części 3D na podst. rysunków | Wynik: 83,5%; koszt: 50,77 dol. | Wynik: 82,5%; koszt: 5,43 dol. | Wynik: 73,1%; koszt: 1,60 dol. |
| FrontierCode | Modyfikacja kodu | Wynik: 45,6%; koszt: 44,7 dol. | Wynik: 44,2%; koszt: 5,97 dol. | Wynik: 43,8%; koszt: 1,29 dol. |
| Harvey-LAB-AA | Analiza prawnicza | Wynik: 7,2%; koszt: 39,84 dol. | Wynik: 15%; koszt: 6,35 dol | Wynik: 11,1%; koszt: 1,92 dol. |
| Terminal-Bench Science | Praca naukowa w terminalu | Wynik: 73,3%; koszt: 45,21 dol | Wynik: 77,1%; koszt: 7,15 dol. | Wynik: 68%; koszt: 2,21 dol |
Nowe modele GPT są już dostępne
Oba modele, a więc zarówno GPT-6.2 Sol, jak i GPT-6.2 Astra, są już dostępne dla wszystkich abonentów w planach Plus, Pro, Enterprise i Edu oraz w aplikacji Codex.